循环神经网络笔记
最近忙着队里招新的事情,太忙了,将近一个月没有更新博客。今天突然想起来,写点博客来记录一下*《动手学深度学习》*的学习过程,这篇主要记录一下循环神经网络(RNN)。
回顾
其实**卷积神经网络(CNN)**的分量也不轻,毕竟在图像处理领域CNN是十分重要,但是没什么时间写了,只能委屈把CNN的内容写到RNN里,权当作为一个回顾和比较了。
线性神经网络
在书中,先是介绍了线性神经网络,利用线性神经网络来求解拟合的问题,当时有时间还顺便做了一下Kaggle上的房价预测,练习了一下数据清洗和预处理,算是对数据科学有了一个基本的认识。
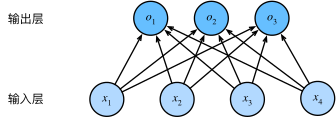
线性神经网络主要是对输入向量的若干的分量进行加权,从而得到输出。这里加权矩阵便是待学习参数。在房价预测问题中,输出只有一个,便是房价(标量)。而在图像分类问题中,可以使用one_hot编码来把输出向量的维度扩展到m维(m为需要分类的数目)。值得注意的是,这里的图像处理方法是把图像由二维展开为一维,从而当做一个width*height的向量而非矩阵来处理,对各个位置的像素进行加权。这样处理有一个问题,就是识别太过笨拙,只会按照对应像素的位置进行加权,图像微小的变换可能就会引起结果的很大差异。
多层感知机
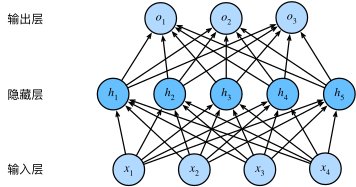
多层感知机可以说才是真正的深度网络,因为它利用现代计算设备的高效性和高并行性,在神经网络中加入了隐藏层,并使用非线性函数(ReLU、tanh)来激活神经元。
权重衰减
为了防止深度学习时过拟合,引入了一种惩罚机制,即权重衰减(weight decay),给损失函数的loss加上一个与权重有关的值,作为对大权重的惩罚。在loss中,结果原来的损失函数和权重衰减项权衡之后,可以得到一个较为理想的、过拟合现象不是很严重的网络。
权重衰减的函数可以使用L1范数、L2范数等等,而该项的系数是一个超参数,需要人工调整,找到一个合适的值。
暂退法
**暂退法(dropout)**暂时没有理解透彻,我现在的理解就是在训练时每个神经元有一定概率输出为0,可能是模拟人的神经元的某种遗忘机制,或者是人为地向网络中加入噪声。这部分先作为一个TODO,将来学明白了来填坑。
卷积神经网络
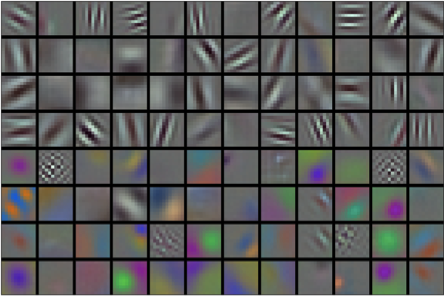
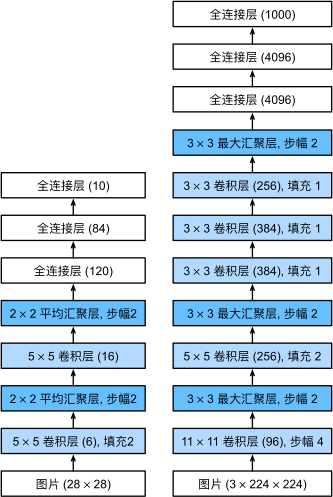
卷积神经网络将二维图像的结构保留了下来,利用核(kernel)对图像进行卷积操作。为了让图像在变换时也有一定的鲁棒性,还引入了池化(pooling,也有人认为翻译成汇聚),池化可以认为是特殊的一种卷积操作,有平均汇聚层和最大汇聚层两种。用大的核对图像卷积时可能会缩小图像,所以这里又涉及了一系列超参数,填充padding、步幅stride、核大小kernel_size。
由于图片有多个通道,所以在对图像进行卷积操作时需要考虑通道的问题。
文中还介绍了现代神经网络,包括深度卷积神经网络AlexNet残差网络ResNet等,这部分就不深入提了。
RNN
终于到正题。上述提到的网络都是仅对当前的输入进行一系列计算,而得出对应的结果。但是,这种学习没有时序性。在自然语言、股价预测、天气预测时,往往需要结合过去的若干个状态来完成输出。
用数学公式表达就是
但是这模型有个缺点,就是随着的增大,需要处理的数据量也会不断增大,针对这个问题,有两个解决办法。
- 只根据前个状态来推出现在的状态,即
- 保留一些对过去的总结,可以用矩阵来表示(可以将其理解为上阶段隐藏层的输出)
实际上,为了减少需要学习的参数个数,RNN使用的是后者。
网络模型
这个矩阵表达的是第t个时间步的状态,可以理解为隐藏层的输出值,矩阵是待学习参数,前者对输入矩阵加权,后者对上个阶段的状态处理。这里的激活函数默认使用ReLU。
要获得输出,还要将此刻的状态输入到一个线性神经网络进行计算,
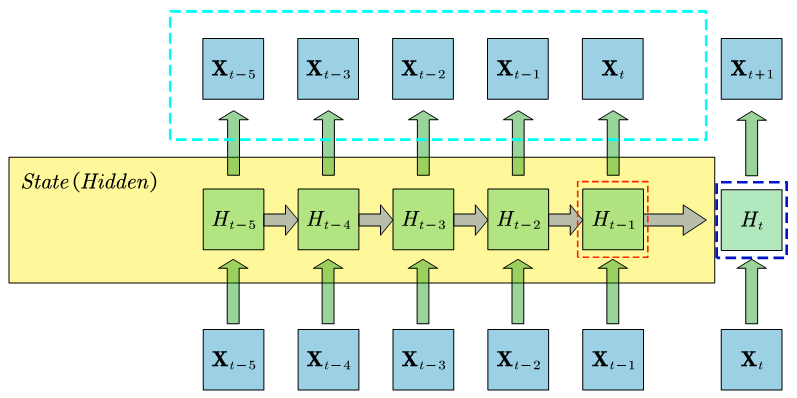
计算新的状态时,只会根据上一个状态和当前输入来计算,再之前的状态只会作为输出(pytorch中)。
训练
训练时,输入的形状为**(时间步数,批量大小,词表大小),这样是为了方便更新小批量数据的隐状态(?),输出大小为(时间步数*批量大小,词表大小)**。在pytorch中封装的RNN会直接返回前个状态(图中淡蓝色框的部分),而非真正的输出,所以想要获得输出还需要再返回的个状态利用线性神经网络进行训练。
测试
测试时,输入大小始终为**(1,1,词表大小)**,因为批量大小显然为1,而输出大小为1,所以时间步数也应该为1。在每次获取预测值之前,都要使用空(可能经过初始化)的状态先在生成的网络上跑一遍,以获得当前上一步的状态。
总结
笔者认为RNN有点confusing,毕竟陌生的马尔可夫链和奇怪的输入输出形状实在棘手。这篇博客可能问题很多,欢迎指出。